多线程1:C++多线程基础和线程池
本章核心:
并发基础知识,如何用C++线程库写出多线程并发程序
并发中的同步机制:竞态条件和互斥锁,条件变量
用1和2的内容实现一个线程池
***********************************我是分割线***********************************
并发很重要,计算机需要通过并发来实现多任务。首先,操作系统本身就是一个很复杂的并发程序。如果没有并发,操作系统连最基本的,例如键盘输入一个字符的同时在屏幕上显示该字符这种人机交互都做不到。因为读取输入再打印到屏幕就已经是一个单线程任务了,但操作系统很明显还需要同时执行很多其它任务。此外,并发在用户态程序中也很常见。还是用上面交互的例子,假如没有并发,一个软件在等待I/O时就不能执行任何其他任务,换句话说就是“卡死”。以上这两个例子都是单核上的并发需求,而如今的计算机随随便便就是十几个甚至是几十个核,在多核上执行的程序很明显也会涉及并发。
并发除了可以降低平均响应时间从而增强交互能力以外, 还可以显著提升某些场景下的效率,最典型的例子就是等待I/O。一个任务等待I/O的时间很显然可以用来执行其他任务。
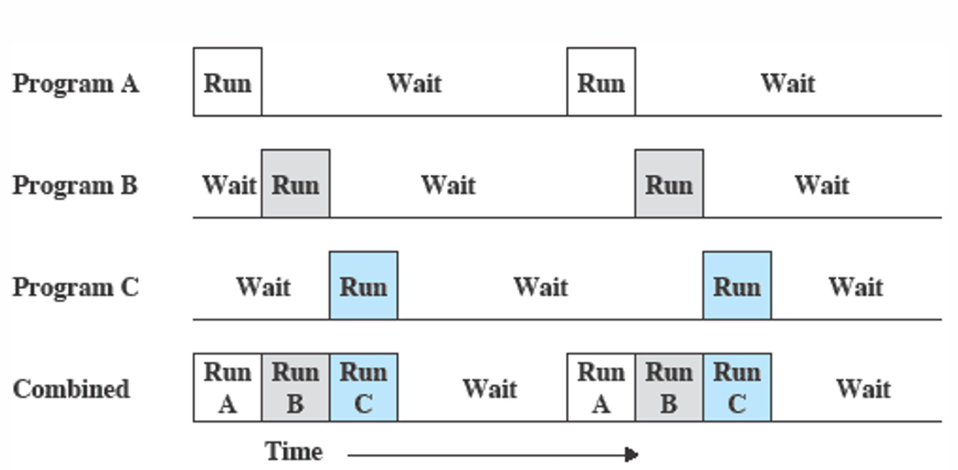
在下面进入正题介绍技术之前,完全不讲并发机制中的进程、线程的原理,不进行概念的辨析等等内容肯定不行,但在入门阶段过度关注进程、线程乃至更多并发机制之间的关系没有太多益处。因此在这里只简单概括一下最最必要的内容,读者有一个感性的认知足矣。简单来说,进程和线程都是抽象概念而非编程语言或者操作系统层面真实的具体实现。在Linux中,只有task这一种程序实体。而编程语言层面的进程和线程都是基于同一个系统调用clone(),传递不同参数创建的在属性上有区别的task。如果task之间的资源,如内存、I/O等都相互隔离,那就叫多进程;而如果资源都共享,那叫做多线程(当然还有其它区别,但是这是主要区别之一)。
上面的解释是从内核的角度,或者说实现原理角度谈进程和线程的区别。而站在用户态的角度来看,多进程和多线程的主要区别在于使用场景。如下图所示,不同的程序常常作为独立的进程加载进内存,而每个程序内部会被拆分成多个子任务交给不同的线程来做(当然也有例外,例如在浏览器中,一般一个网页就是一个进程)。
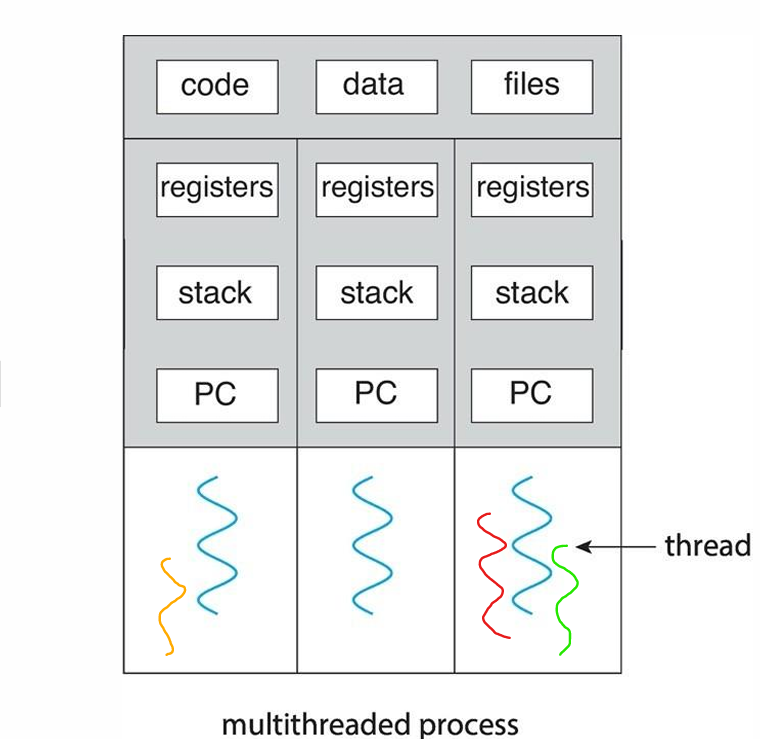
我们接下来将聚焦在多线程上,讨论怎样在单个程序内部使用多线程,从而达成充分利用多核和解耦不同任务的两个核心目的,并基于此实现业务功能和提升执行效率。下面直接从一个具体的例子开始。
1.1 C++多线程入门
假设一个维护个人信息数据集合的程序需要同时:
依据外接设备,例如摄像头、指纹识别器来实时更新数据集合中的内容
通过键盘输入操作数来执行增删查改等操作
这个程序就可以通过将上述两个子任务交给两个线程同时执行来实现。
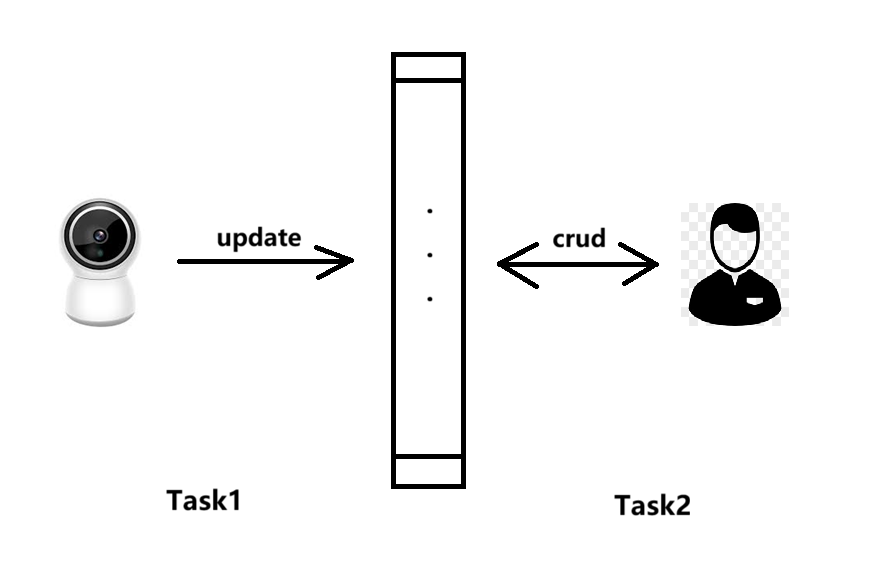
当然这个功能太具体了,但这些具体功能完全可以用简单的数据结构模拟一下,只保留多线程的部分。例如,线程A执行以下程序,生成随机数,并将随机数存入数组内,模拟数据不断从外设传来和维护数据集合的行为:
#include <vector>
#include <random>

void random_update(std::vector<int> &arr, bool &open){
    int index = 0;
    std::mt19937 gen(std::random_device{}());     // 随机数引擎
    std::uniform_int_distribution<> dist(1, 10);  // 均匀分布 [0,10]
    while (open){
        if (index == 10){
            index = 0;
        }
        int x = dist(gen);
        arr[index] = x;
        ++index;
    }
}
线程B执行以下程序,接收操作数,依据操作数来计算集合中所有值的和或积并打印到标准输出流,模拟对增删查改的支持:
#include <iostream>
#include <vector>

void sum_or_product(std::vector<int> &arr){
    char a;
    while(1){
        std::cin >> a;
        if (a == '0'){
            int sum = 0;
            for (int i = 0; i < 10; ++i){
                sum += arr[i];
            }
            std::cout << "sum: " << sum << std::endl;
        } else if (a == '1'){
            int product = 1;
            for (int i = 0; i < 10; ++i){
                product *= arr[i];
            }
            std::cout << "product: " << product << std::endl;
        } else {
            break;
        }
    }
}
有了任务,剩下的任务就是调用接口将这两个任务交给不同的线程,如下:
#include <thread>
#include <vector>

int main(){
    bool open = true;
    std::vector<int> arr(10);
    std::thread thread1(random_update, std::ref(arr), std::ref(open));
    std::thread thread2(sum_or_product, std::ref(arr));
    if (thread2.joinable()){
        thread2.join();
    }
    open = false;       // 通知thread1结束
    if (thread1.joinable()){
        thread1.join();
    }
    return 0;
}
C++多线程最基础的调用就构造,join(),joinable(),以及上面的代码中没有展示的detach()。
首先是构造函数:
第一个参数可以是任何可调用对象。在这里传递的函数名会退化为函数指针,当然也可以显示传递函数指针,lambda表达式等等。
后续为按照顺序传入的调用该函数的参数。此处传参和普通的函数传参类似,传值也是拷贝传递,需要跨函数操作就需要传递指针或引用等。需要注意,在一般函数调用中,引用引用和值传递的形式一致,由被调用函数的函数签名决定。但在初始化线程执行一个函数时,引用传递需要用std::ref()显示指定。
剩下三个同步机制放一起讲:
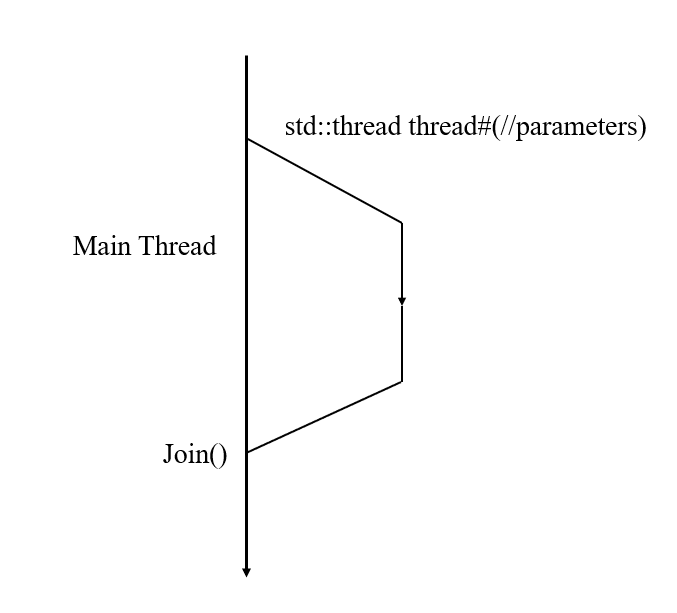
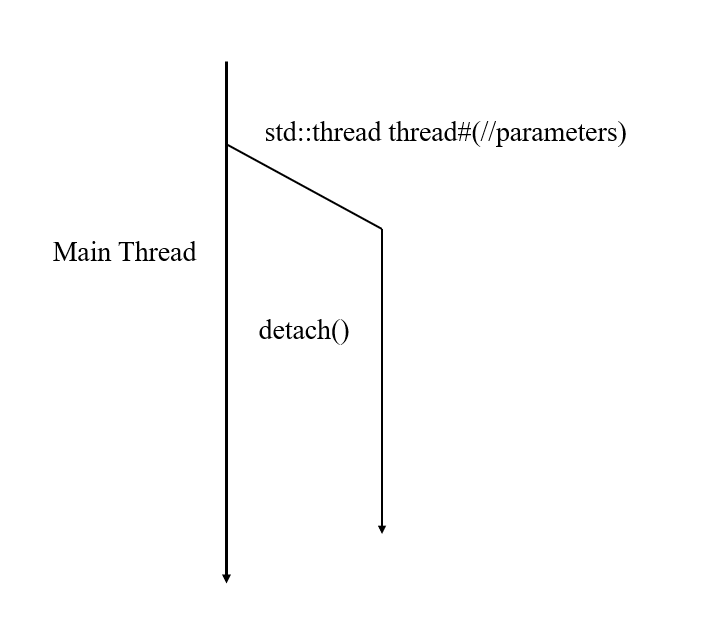
- join():阻塞等待该线程结束。个人对这个接口的名字的理解是,主线程在等待子线程执行完毕以后,重新join进入主线程,如下图所示:
- detach():将该线程的控制权交给操作系统,作用在于让该线程持续存在。被detach的函数在函数的主线程结束后不会和主线程一同回收,因此通常用于开启诸如日志线程等需要一直在后台运行的线程。当然在main()中调用detach没什么意义,只可能会在其他函数中调用。因为main()结束,也即整个进程都结束后,线程就算被detach也会被操作系统一同回收。在这里就不做演示了。
- joinable():用于判断一个线程是否可以join。joinable为false的情况常见为三种:线程默认构造没分配任务,线程已经被detach,线程被move走了。
多线程的基础接口主要就这么几个,并不复杂。用到thread的程序在编译时要加上-pthread,尝试编译运行看效果的时候记得加上。
1.2 数据竞争
可能有部分读者应该已经意识到了,多线程共享数据的特点有可能会导致数据竞争问题,当两个不同的线程对同一个共享数据进行操作时就可能会发生数据竞争。例如,线上购物商城中的货物的总量确定,现在来自两个不同用户的购买请求被两个不同线程同时处理。按理来说,总数量应该由n变为n-2,可由于读到值n和写回值n-1之间一定有一个时间间隔,那么就可能出现线程A读到n,在还没来得及将写回n-1的情况下,线程B也读到了n,最后两个线程就会向内存中写回同一个值n-1。
上面的例子是减,而加当然有可能面临同样的情况。下面这段代码中的两个线程的确分别做了1000000次++,但结果却小于0+1000000+1000000=2000000。
#include <thread>
#include <iostream>

void thousand_times_add(int &a){
    for (int i = 0; i < 1000000; ++i){
        ++a;
    }
}

int main(){
    int a = 0;
    std::thread thread1(thousand_times_add, std::ref(a));
    std::thread thread2(thousand_times_add, std::ref(a));
    thread1.join();
    thread2.join();

    std::cout << a << std::endl;

    return 0;
}
在自己尝试编译运行这段代码的时候可以自行修改循环次数,但请确保循环的次数足够多。++较少的次数如1000或10000次仅需非常短的时间(1000次++可能1μs都不需要),因此很有可能第一个线程已经执行完全部1000次++,第二个线程才开始执行,最终结果反而正确的情况。
这个问题的解决思路朴素且直观:给共享资源加锁,锁的行为确保只有一个线程能成功加锁,且只有加锁成功的线程可以继续向下执行,其它线程在加锁的位置等待。当加锁的线程结束对共享资源的访问后会解锁,等待锁的线程此时再次尝试抢锁。
互斥锁是最常用的一种锁。通过C++封装好的mutex库,上面出现数据竞争的代码在加锁以后即可保证结果正确:
#include <thread>
#include <iostream>
#include <mutex>

void thousand_times_add(int &a, std::mutex &mtx){
    for (int i = 0; i < 1000000; ++i){
        mtx.lock();
        ++a;
        mtx.unlock();
    }
}

int main(){
    int a = 0; std::mutex mtx;
    std::thread thread1(thousand_times_add, std::ref(a), std::ref(mtx));
    std::thread thread2(thousand_times_add, std::ref(a), std::ref(mtx));
    thread1.join();
    thread2.join();

    std::cout << a << std::endl;

    return 0;
}
加锁后和解锁前的代码段被称为临界区。无论两个线程如何交替,只有拿到锁的线程可以进入临界区,执行++a操作。另外一个线程只能等待锁被释放以后再次尝试加锁,否则永远进入不了临界区执行++a操作。
锁的行为其实同时暗示了加锁的利和弊。互斥锁解决了数据竞争问题,这是利;可如果占有锁的线程因为某种原因在终止后都没有释放锁,那另一个线程就始终无法往下运行,从而导致程序卡死,这是弊。或许有读者会疑惑,结束了还没释放锁那不就是程序员粗心大意忘记了?诚然,在上面这种简单的程序中很难忘掉解锁,就算忘记了也很容易修改正确,但这里其实并不只是在讨论粗心大意的问题。复杂的业务代码可能需要处理极度复杂的锁释放。例如,返回的情况下如何释放锁?出错了又该如何释放锁?如果按照上面的方式操作和管理锁,大型项目中的锁管理将变得极其复杂。可能已经有人意识到了,这里所面临的问题和指针的管理其实一模一样,因此,C++中用于管理指针的**Resource Acquisition Is Initialization(RAII)**思想同样完美适配锁资源的管理。既然在线程结束时必须释放锁,那能否将锁与线程的生命周期绑定呢?对象就非常适合用来搭建锁和线程生命周期之间的桥梁。将加锁和解锁操作分别封装在构造函数和析构函数中,这样在线程结束时,作为临时资源的对象会被释放并自动调用析构函数,从而释放锁。
在这里首先介绍lock_guard:
#include <thread>
#include <iostream>
#include <mutex>

void thousand_times_add(int &a, std::mutex &mtx){
    for (int i = 0; i < 1000000; ++i){
        std::lock_guard<std::mutex> lock(mtx);
        ++a;
    }
}

int main(){
    int a = 0;
    std::mutex mtx;
    std::thread thread1(thousand_times_add, std::ref(a), std::ref(mtx));
    std::thread thread2(thousand_times_add, std::ref(a), std::ref(mtx));

    thread1.join();
    thread2.join();

    std::cout << a << std::endl;

    return 0;
}
调用lock_guard的构造函数,初始化实例时需要传入锁。锁资源会在构造函数内获取,在析构函数中释放。
我们通过互斥锁解决了数据竞争,但除数据竞争以外,部分其他场景也涉及线程行为的管理。当对共享数据的操作不再只是读取和修改,还涉及增加和减少时,新的问题出现了。考虑下图:
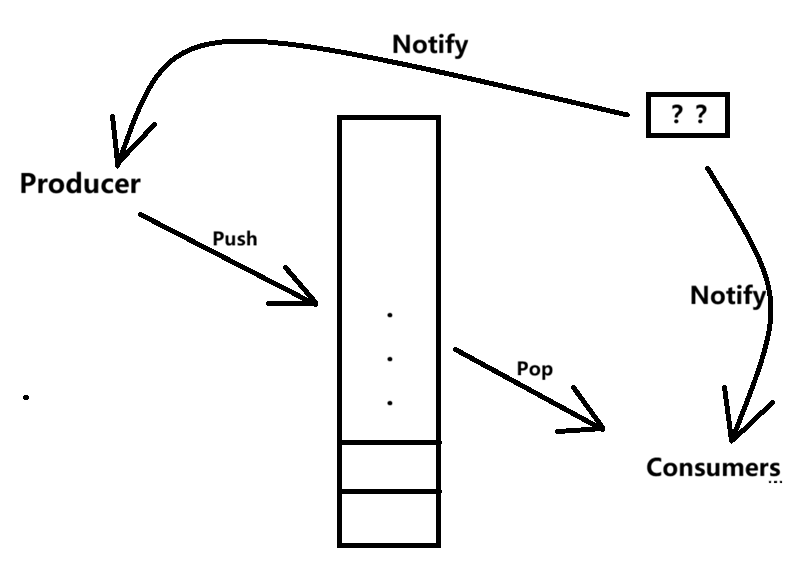
图中的模型被称为生产者-消费者模型。生产者和消费者都可以同时存在多个,分别往队列中添加元素和取出元素。如果队列有界,当队列满时需要阻止生产者线程添加任务,当队列空时需要阻止消费者继续取出任务;就算队列无界,为动态缓冲区,也需要阻止消费者在队列为空时继续取任务。与用锁控制线程进入临界区或等待类似,条件满足情况下线程的行为也可以用标识来控制,其中一种机制叫做条件变量,也即图中“??”所代表的机制。需要说明,cv本身是和锁配合一起使用的,其本身并不直接涉及任何的数据竞争问题,它说白了就只是一个能控制线程休眠苏醒,记录线程状态的类而已。在后面还会介绍一些其他用于控制线程休眠唤醒的机制,它们都不直接和数据竞争相关,都只用于给锁提供某种配套服务(例如线程的休眠唤醒,跨越声明周期传递值等等)。
下面这段代码用无界队列+条件变量实现了一个简单的生产者消费者模型,其中生产者和消费者各有一个:
#include <thread>
#include <condition_variable>
#include <queue>
#include <iostream>
#include <mutex>

std::queue<int> q;
std::mutex mtx;
std::condition_variable cv;


void producer(){
    for (int task = 0; task < 10; ++task){
        std::lock_guard<std::mutex> lock(mtx);
        q.push(task);
        cv.notify_one();
        std::cout << "produce task " << task << std::endl;
    }
    //std::this_thread::sleep_for(std::chrono::microseconds(100));
}

void consumer(){
    while (true){
        std::unique_lock<std::mutex> lock(mtx);
        cv.wait(lock, [] () {return !q.empty();});
        int task = q.front();
        q.pop();
        std::cout << "consume task " << task << std::endl;
    }
}


int main(){
    std::thread thread1(producer);
    std::thread thread2(consumer);

    thread1.join();
    thread2.join();
    return 0;
}
这段代码适合从consumer函数开始分析,恰好三个需要解释的接口也都和consumer函数关联。
wait()是条件变量的成员函数。需要传递两个参数:
std::unique_lock。和前面讲到的lock_guard类似,unique_lock也是基于RAII思想而诞生的产物,可以视作lock_guard的扩展。前面讲到,加锁和解锁等锁操作都被封装在lock_guard成员函数内部,lock_guard并不提供加解锁的接口,解锁操作只能在触发析构函数时在析构函数内部完成。而wait()的函数(见下)需要传入的锁支持手动解锁,因此需要使用提供了解锁接口std::unique_lock::unlock()的unique_lock类。
布尔类型的函数指针。在这里是lambda表达式。
程序执行到wait()时,会调用传入的布尔类型函数指针,结果为true继续向下执行,为false则会释放锁(调用上面讲到的unique_lock.unlock())并阻塞线程,等待其它线程调用cv.notify_one()唤醒。在被唤醒以后,线程会调用unique_lock.unlock()尝试抢占互斥锁,直至加锁成功继续向下执行。
补充说明,调用过cv.wait()的线程除了可以被cv.notify_one()唤醒其中一个以外,还会被其他线程调用cv.notify_all()一次性全部唤醒。
1.3 阻塞队列线程池
在前面的讨论中,我们感受到了多线程作为并发工具的强大,也认识并解决了其同时带来的线程安全问题。然而除了线程安全,多线程的使用代价同样值得关注,这其中包含了多线程创建和销毁的开销,以及线程上下文切换所带来的CPU和内存压力。受效率方面的考量,如今常会采取线程池来集中管理线程,从而实现对线程规模和行为的控制,进而降低使用成本,实现对多线程任务执行的管理。这便是线程池的两个核心目的:1复用多线程资源和控制多线程规模从而降低成本,2统一管理线程行为和生命周期从而统一任务调度与执行模型。下面我们结合实现来看看线程池如何做到上述两点。以下是一个经典的阻塞队列线程池接口:
class ThreadPool {
public:
    explicit ThreadPool(int threads_num);
    ~ThreadPool();
    void post(int task);
private:
    void work();
    BlockingQueue task_queue_;
    std::vector<std::thread> workers_;
};
可以发现这些接口很好地对应了前面说到的两点:
线程池维护固定数量的线程并用一个数列管理起来。线程池在初始化时创建固定数量的线程,这些线程会被反复使用,最终和线程池的生命周期同步结束。这种实现方式保证了线程规模受控,从而控制上下文切换开销并复用线程,避免了反复创建与销毁线程的开销。
线程池不仅管理线程的数量和规模,还实现了对线程的调度。线程池对外提供线程辅助执行任务,那么也就需要在管理线程的同时,一并管理对外接收任务和内部执行任务的行为。因此,线程池需要一个私有成员变量来作为任务的缓冲区,并在内部实现任务执行的机制,仅对外暴露向线程池中提交任务的接口。在上面的实现中,起到缓冲区作用的是BlockingQueue阻塞队列,对外暴露的唯一接口是用于任务提交的post()。
BlockingQueue的具体结构我们还没设计,但它作为一个队列,应当拥有基本的push和pop接口。我们可以先基于此尝试实现线程池:
#pragma once
#include <iostream>
#include <vector>
#include <queue>
#include <thread>

class ThreadPool {
public:
    explicit ThreadPool(int threads_num){
        for (size_t i = 0; i < threads_num; ++i) {
            workers_.emplace_back(/*???*/);
        }
    }

    ~ThreadPool(){
        for(auto &worker : workers_) {
            if (worker.joinable())
                worker.join();
        }
    }

    void post(int task){
        task_queue_.push(task);
    }
}
析构函数和post()都很简单,不做赘述。值得一提的是构造函数。构造函数需要初始化n个线程并全部填入线程数组workers里,但每个线程用什么函数启动呢?按照我们上面的设计,数组中的任务由外部调用者调用post()接口提交,而worker负责从队列中取出任务执行。那么线程应该执行的任务就应当是调用队列的pop接口并执行它,也就是执行下面函数:
void work() {
    while (true) {
        int task;
        if (!task_queue_.pop(task)) {
            break;
        }
        std::this_thread::sleep_for(std::chrono::milliseconds(100));
        std::cout << "Task " << task << " executed by thread " << std::this_thread::get_id() << std::endl;
    }
}
在这里还是用int代表任务类型,并用打印模拟了任务执行。此外work()函数里必须要有一个循环执行的推出接口,不然前面的析构函数会永远阻塞在worker.join()。这里利用了还没有设计的pop()来做为退出信号。这是对pop()行为的第一个要求:pop()的返回值类型为bool,true代表成功弹出,false代表队列关闭弹出失败。
依据这个work()函数可以补齐构造函数:
explicit ThreadPool(int threads_num){
    for (size_t i = 0; i < threads_num; ++i) {
        workers_.emplace_back([this] {work();});
    }
}
括号里的lambda表达式会调用std::thread用lambda表达式定义的构造函数,生成一个执行work()函数的线程,并加入线程数组workers的尾部。然而问题随之而来:线程一经创建便会开始尝试从阻塞队列中取执行任务。可在刚刚初始化的当下,阻塞队列几乎一定为空。这意味着,我们必须采取某种机制使得work()函数可以阻塞在某个地方,直到队列中有任务可取再继续执行。回顾work()的执行流程,能发现唯一合适且可行的阻塞位置便是task_queue_.pop()。这是对pop()行为的第二个要求:调用pop()的线程在队列为空时必须阻塞,而这个行为不恰恰就是我们在第二部分通过条件变量实现的consumer()吗?!不仅如此,push()接口需要做到的往队列里添加任务也刚好和producer()一致!我们由此非常自然地引出了阻塞队列的设计(顺便也解释了它为什么叫“阻塞”队列)。可以发现,除了不再需要循环添加任务和循环执行任务以外(循环本身也不该是队列的任务,只是前面的生产者消费者模型需要演示,所以加入了循环而已),就是生产者消费者模型的严格1:1照搬:
#pragma once
#include <queue>
#include <condition_variable>
#include <mutex>

class BlockingQueue {
public:
    void push(const int &task){
        std::lock_guard<std::mutex> lock(mutex_);
        queue_.push(task);
        not_empty_.notify_one();
    }

    void pop(int &task){
        std::unique_lockstd::mutex lock(mutex_);
        not_empty_.wait(lock, [this]{return !queue_.empty()});
        task = queue_.front();
        queue_.pop();
    }

private:
    std::queue<int> queue_;
    std::mutex mutex_;
    std::condition_variable not_empty_;
};
但我们上面说过,必须要在pop()中设计队列关闭,返回bool值的退出机制。为解决这个遗留问题,我们模仿第一部分中的演示代码,在阻塞队列中新添加一个可供外部调用,通知所有线程线程优雅退出的cancel()接口和一个bool类型私有属性closed_。closed_默认为false,只在调用cancel()时才被修改为true用于通知所有线程结束。
改动汇总如下:
BlockingQueue加入新的私有属性closed_,加入构造函数设置其默认值为false,加入cancel()方法修改其值为true
修改pop()中wait()的判断条件,将这个信息由返回值传递给work()函数。修改pop()的返回值为bool,wait()新增判断条件。
ThreadPool的析构函数需要调用cancel()
上述改动对应的修改不再单独列出,直接展示修改后完整的基于阻塞队列的线程池:
#pragma once
#include <iostream>
#include <vector>
#include <queue>
#include <thread>
#include <mutex>
#include <condition_variable>

class BlockingQueue {
public:
    BlockingQueue(bool closed = false): closed_(closed){ }

    void push(const int &task){
        std::lock_guard<std::mutex> lock(mutex_);
        queue_.push(task);
        not_empty_.notify_one();
    }

    bool pop(int &task){
        std::unique_lock<std::mutex> lock(mutex_);
        not_empty_.wait(lock, [this]{return !queue_.empty() || closed_;});
        if (!queue_.empty()) {
            task = queue_.front();
            queue_.pop();
            return true;
        } else {
            return false;
        }
    }

    void cancel(){
        std::lock_guard<std::mutex> lock(mutex_);
        closed_ = true;
        not_empty_.notify_all();
    }

private:
    bool closed_;
    std::queue<int> queue_;
    std::mutex mutex_;
    std::condition_variable not_empty_;
};


class ThreadPool {
public:
    explicit ThreadPool(int threads_num){
        for (size_t i = 0; i < threads_num; ++i) {
            workers_.emplace_back([this] {work();});
        }
    }

    ~ThreadPool(){
        task_queue_.cancel();
        for(auto &worker : workers_) {
            if (worker.joinable()) worker.join();
        }
    }

    void post(int task){
        task_queue_.push(task);
    }

private:
    void work() {
        while (true) {
            int task;
            if (!task_queue_.pop(task)) {
                break;
            }
            std::this_thread::sleep_for(std::chrono::milliseconds(100));
            std::cout << "Task " << task << " executed by thread " << std::this_thread::get_id() << std::endl;
        }
    }

    BlockingQueue task_queue_;
    std::vector<std::thread> workers_;
};
最后需补充说明:线程池的构造函数一定要加上explicit,要特别注意避免隐式转换,因为线程池是重型+副作用很大的资源。将ThreadPool和同一份文件中的BlockingQueue比较,后者就算发生隐式转换也不过是生成了几个变量而已,但线程池一旦被隐式转换启动就会直接创造新的线程。这两者的隐式转换所带来的开销完全不是一个量级。当然,并不是说错误的隐式转换,但是量级轻就可以忽略,也不是说所有的构造函数都得加个explicit,而是说,这种重型资源的构造通常明确不允许隐式转换,也就是根本就不应该考虑“为重型资源设计隐式转换”这回事,哪怕是正确地使用也不行;而轻型资源在语义自然的情况下,可以较为小心地使用隐式转换。